El problema
Recoger ofertas de 13 portales significa ver muchas veces la misma oferta, publicada en sitios distintos. La mayoría tampoco encaja con el perfil, y eso solo se sabe después de leerla.
Quería que un modelo de IA hiciera esa lectura. Pasarle todas las ofertas sería lento y caro, y muchas se descartan con una regla simple. Por eso el modelo entra al final, donde las reglas ya no alcanzan.
Reglas primero, modelo después
Antes de llamar al modelo, Criba elimina duplicados en cuatro pasadas. La primera compara el identificador de la fuente y la segunda la URL canónica. La tercera busca títulos parecidos dentro de un mismo empleador. La cuarta compara las ofertas sin empleador con el resto del lote.
Después filtra en dos fases, antes y después de descargar el detalle de cada oferta. Ese cambio volvió útil a un portal donde antes sobrevivía 1 oferta de 969.
El resultado se ve en la base. De 40.015 ofertas únicas, 3.210 (8,0 %) llegaron al juez. El resto lo resolvieron la deduplicación y las reglas, sin gastar una llamada al modelo.
| Paso | Ofertas |
|---|---|
| Ofertas únicas guardadas de 13 portales | 40.015 |
| Llegan al juez, tras la deduplicación y las reglas | 3.210 (8,0 %) |
| Avisos de la primera persona con una decisión, sí o no | 63 |
El contrato del juez
El juez recibe lotes de 20 ofertas numeradas y responde con una estructura fija. Un modelo Pydantic la valida con 4 campos obligatorios y sin valores por defecto, así que una respuesta a la que le falte un campo no pasa la validación.
Cada veredicto vuelve a su oferta por el número. Si no se puede emparejar, se descarta y Criba no intenta adivinar a cuál pertenecía. Prefiero perder un veredicto antes que pegarle a una oferta la puntuación de otra.
Cómo mido al juez
Para medir si el juez acierta con lo que cada persona quiere, uso sus decisiones como etiquetas. Criba empezó para una persona y hoy atiende a dos, cada una con sus palabras clave y su umbral en un archivo propio. Las dos comparten un canal donde reaccionan a las ofertas, y cada reacción cuenta para quien la pulsó.
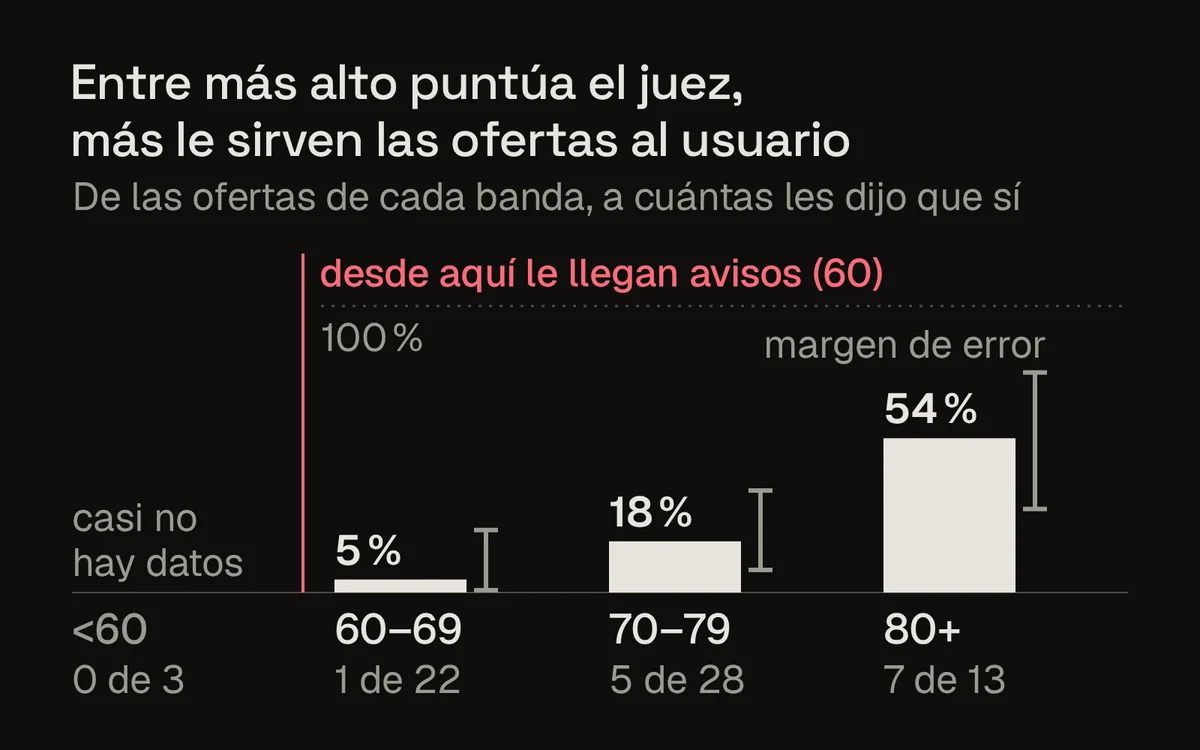
Sobre esas etiquetas construí un informe de umbrales. Agrupa las ofertas por bandas de puntuación y compara cada banda con lo que cada persona decidió, postular o descartar. Exige al menos 10 respuestas por banda antes de sugerir nada, y una banda solo queda por encima del umbral si se postuló al menos al 25 % de sus ofertas.
El juez empezó en Gemini; pasarlo a Claude Sonnet movió su escala, así que bajé los umbrales como parche antes de elegirlos con las decisiones, como cuento en este artículo.
| Banda | Dijo que sí | Tasa | Margen de error (95 %) |
|---|---|---|---|
| 60–69 | 1 de 22 | 5 % | 1–22 % |
| 70–79 | 5 de 28 | 18 % | 8–36 % |
| 80+ | 7 de 13 | 54 % | 29–77 % |
La tasa sube de una banda a la siguiente, así que la puntuación del juez sí sigue lo que esa persona quiere, aunque con 13 a 28 respuestas por banda los márgenes se solapan. Solo la banda de 80 en adelante pasa del 25 %, y por eso el informe sugiere subir su umbral de 60 a 80.
No lo subí. En las bandas de 60 a 79 están 6 de sus 13 postulaciones, y con 80 ninguna le habría llegado como aviso. Con 28 respuestas, el 18 % de la banda 70–79 tiene un margen amplio, de cerca de 8–36 %, que todavía cruza el mínimo. Leer avisos de más cuesta menos que perder una postulación, así que el umbral sigue en 60 y el informe se vuelve a correr a medida que llegan respuestas.
¿Y por qué no 70? La banda de 60 a 69 no llega al 25 % ni en su límite alto, el 22 %, así que con 70 la regla también se cumpliría. Subirlo ahorraría 22 avisos y costaría 1 de las 13 postulaciones. Con tan pocas, perder una pesa más que leer 22 avisos de más, y por eso no lo moví.
| Umbral | Avisos con decisión | Postulaciones que llegan | Tasa |
|---|---|---|---|
| 60 (el actual) | 63 | 13 de 13 | 21 % |
| 70 | 41 | 12 de 13 | 29 % |
| 80 | 13 | 7 de 13 | 54 % |
Además, las etiquetas solo existen para las ofertas que llegaron al canal, así que el informe puede decir que conviene subir un umbral, pero no qué se pierde por debajo.
Lo que se rompió en producción
Los peores fallos fueron los silenciosos. En septiembre, cuando un portal limitaba una búsqueda, el recolector leía el rechazo como “no hay más resultados”, se saltaba todas las búsquedas siguientes y terminaba el barrido en verde. Lo detecté porque un ciclo completo con 25 palabras clave terminó todas las fuentes en 109 segundos, cuando solo la grilla de búsquedas de ese portal necesita unos 12 minutos. Ahora un límite de peticiones se trata como un rechazo, y el siguiente ciclo retoma donde se cortó.
En octubre, una auditoría de los datos de producción mostró que la búsqueda rotativa de un portal, la que produce las ofertas que más sobreviven a los filtros, había buscado solo las palabras clave de la primera persona, ninguna de la segunda. Cada búsqueda rotativa guardaba su posición en memoria, así que cada despliegue la devolvía al principio. Ahora las rotaciones guardan su posición en disco, y las palabras clave de las dos personas se intercalan.
Cada uno de estos fallos quedó en un registro de decisión con qué se rompió, cómo se detectó y qué cambió.
Cómo está construido
Arquitectura hexagonal en cuatro capas (dominio, adaptadores, aplicación e interfaz) con una sola raíz de composición. Cada ciclo corre 15 recolectores, con httpx y Playwright, sobre 13 portales y valida los datos con Pydantic. Cada persona recibe aviso según su propio umbral. Los datos viven en PostgreSQL, en un contenedor junto a Criba en el mismo servidor. Lo saqué de Supabase en octubre, cuando las lecturas completas y los respaldos nocturnos agotaron la transferencia gratuita del plan.
Python 3.13 gestionado con uv, con mypy –strict relajado solo en los adaptadores de scraping, y SQLAlchemy 2.0 tipado con 14 migraciones de Alembic. El despliegue lo dispara CI en el VPS por SSH, con una clave limitada a un solo comando. El contenedor corre sin root, y el respaldo nocturno conserva 7 copias diarias y 8 semanales.
Lo que compruebo antes de desplegar
Reviso cada cambio antes de aceptarlo, y lo que se puede convertir en regla lo dejo en CI. Cuatro contratos de arquitectura hacen fallar el build si un import cruza las capas. Seis controles tienen que pasar antes de desplegar, entre ellos los tipos estrictos y una cobertura de ramas mínima del 95 % que solo puede subir.
El despliegue no migra la base sin una copia nueva, y al terminar verifica que el contenedor pasa su chequeo de salud y corre el commit construido. En producción, una señal de vida por ciclo separa un proceso que avanza de uno colgado que Docker seguiría viendo en buen estado.
Límites
La lectura del umbral descansa en las 63 decisiones de una sola persona en las bandas que recibe como aviso; para la segunda solo se puede leer la banda más baja. Una decisión tampoco es un resultado final: no se registra nada de lo que pasa después, así que puedo decir sobre qué alertas actúan las personas, no a qué llevan.