AI Engineer
Outrix Intelligence agosto de 2026 – actualidad
Evalúo contra decisiones reales: comparo las puntuaciones de un modelo con lo que las personas decidieron en realidad, y fijo el umbral de aprobado antes de correr una prueba, no después.
Trabajo en todo el sistema que rodea al modelo: los datos que recibe, la aplicación que lo usa y el código que decide qué hacer con su respuesta.
Llevo tres años entregando software en producción y, desde 2025, integrando modelos de lenguaje en flujos de automatización. De ahí vienen los hábitos que aplico: diagnosticar fallos a partir de los logs, dejar reintentos en cada integración y migrar datos sin perder un registro.
Me hago cargo de punta a punta de los sistemas que construyo y fijo las reglas con las que salen a producción: qué puede decidir el modelo, qué se mide y qué bloquea un cambio. Parto de un problema que todavía no está definido, acuerdo con quien decide qué cuenta como resuelto y lo sostengo en producción.
Outrix Intelligence agosto de 2026 – actualidad
Boson Planning mayo de 2025 – agosto de 2026
octubre de 2023 – agosto de 2026
Antes de cambiar un prompt o un modelo, leo respuestas reales y anoto dónde fallan. Una métrica general avisa de que algo va mal; un fallo leído dice qué arreglar.
Si los pasos se conocen, los escribo en código. El modelo entra solo donde las reglas se rompen, y un agente solo donde el camino no se puede prever. Cada capa extra tiene que justificar su costo.
Cada respuesta del modelo llega con una forma definida y se valida antes de tocar nada. Lo que no cuadra se rechaza y queda registrado: un sistema que adivina en silencio es peor que uno que falla a la vista.
Un cambio de prompt, de modelo o de datos se prueba contra casos reales antes de salir. Una comparación pequeña alcanza para decidir, no para dar la pregunta por cerrada, así que la regla a la que apunto es un conjunto de casos que crezca con el sistema y contra el que corra cada cambio. Donde todavía no hay casos, una persona aprueba cada salida. El código que escriben mis agentes pasa por los mismos controles y por mi revisión.
Claude
Gemini
Claude Code
MCP
Python
Pydantic
FastAPI
TypeScript
PostgreSQL
Supabase
n8n
Docker
GitHub Actions
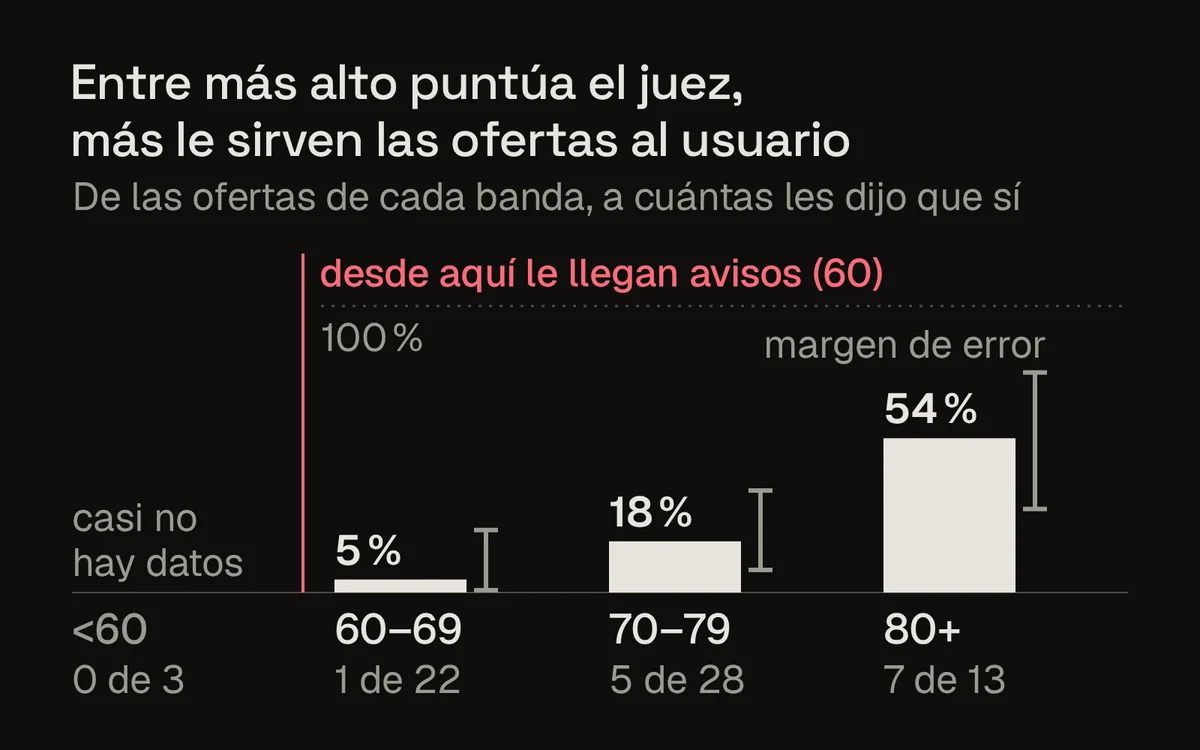
Revisa 40.015 ofertas y solo envía al juez de IA el 8 % que sobrevive a reglas fijas; el umbral de aviso se eligió según la tasa de postulación en cada banda de puntuación.
Ver proyecto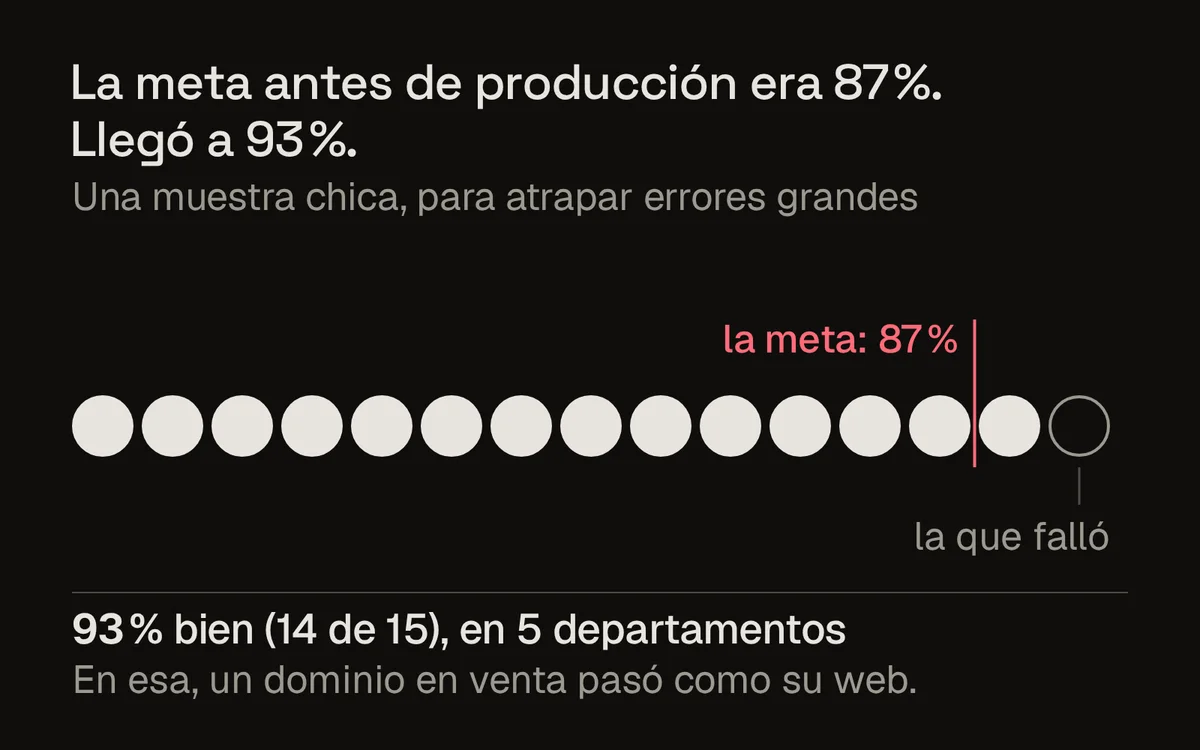
Ningún modelo investiga una empresa antes de que una persona confirme cuál es, y ninguno puntúa prospectos sin datos sobre quién termina siendo cliente. Es la regla de las herramientas comerciales que construí para una firma de datos e IA, entre ellas un directorio de 30.858 empresas colombianas.
Ver proyectoEscríbeme sobre un fallo que tu modelo no deja de repetir, o sobre algún principio de los de arriba que discutirías. Esos son los correos que contesto primero.
Contacto
Escríbeme a
Haz clic para copiarAbrir en tu correo ↗